一家创业公司的算力账本是这样的:今年年初,全公司月消耗词元约40亿;如今创始人单月就能消耗1500亿。他一个人同时运行四五个智能体自主作业,算力成本翻了十倍,全公司约80%的支出投向算力和数据。
账单为什么涨得这么快?智能体从“问答”走向“执行任务”,一项工作要经过多轮推理、调用工具、检查结果,消耗自然上去。行业里讨论的递归自我改进,让研发模式从人工编写转向智能体自主迭代,直接带动词元消耗出现十倍级增长。但花钱多不等于应用好,真正该算的是完成一项合格任务花多少钱、省多少时间。
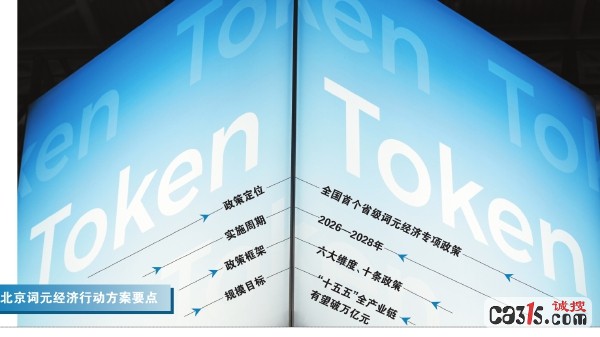
政策端开始托底。9月18日,北京市经济和信息化局、市发展改革委联合发布《北京市加快词元经济发展的行动方案(2026—2028年)》,这是全国首个省级层面的词元经济专项政策,围绕生产、定价流通、场景应用、国际合作、数据要素利用、要素保障六个维度推出十条核心措施。官方预测,词元经济全产业链在“十五五”期间整体规模有望突破万亿元。
供给端同步扩容。北京亦庄人工智能公共算力平台已建成全市最大的5000P公共算力平台,万P国产算力中心上架首批算力;北京数字经济算力中心、京西智谷人工智能计算中心等载体同步布局。工信部已明确探索“算力银行”“算力超市”等模式,支持企业把闲置算力存入平台,跨区域、跨周期调度取用。
降本可以分三层看:模型与国产芯片适配、模型轻量化和推理优化,提升单位算力产出的词元价值;统一接口和公共分发平台建设,减少企业反复适配、独立部署的额外开支;配套专项金融产品和中长期信贷,缓解前期算力投入的资金压力。这些效果会随项目落地逐步释放。
对中小企业来说,最实际的变化是不必再长期绑定大额算力预付协议,可以像买水电一样按需付费,闲置算力还能存入平台兑换额度。但要评估数据安全、迁移成本和供应商锁定;算力便宜了,不加节制地调用一样烧钱。
(信息来源:北京商报)
声明:本文系诚搜号作者或机构在315诚搜网上传并发布,不代表315诚搜网观点。转发此文章,旨在为读者提供更多信息资讯,所涉内容不构成投资、消费建议。申请诚搜号,请访问:mp.ca315.com。
评论
您的举报信息,对我们很重要。平台核实后会处理。侵权、隐私等问题也可以向我们的邮箱发送删帖申请函。邮箱:chengsouwang@ca315.com 详情请参照《3.15诚搜网删除帖子及相关管理规定更新发布》